Zastosowania Asystent RAG
RAG z pełną suwerennością danychLokalny Asystent RAG: Wewnętrzna Baza Wiedzy 100% On-Premise
Zamień firmowe dokumenty w asystenta, który odpowiada w kilka sekund i wskazuje źródło — na Twoim serwerze, zgodnie z RODO i EU AI Act.
- Dokumenty nie opuszczają firmy
- Odpowiedź z odnośnikiem do źródła
- Działa bez dostępu do internetu
- Bez opłat za tokeny i kroki
Odpowiedzi dla użytkowników od razu, bez czytania setek stron.
Instrukcje, wytyczne, regulaminy i umowy stają się asystentem, który odpowiada na pytanie w kilka sekund i pokazuje, z którego dokumentu wzięła się odpowiedź. System uruchamiasz bezpośrednio na serwerze firmowym lub stacji roboczej — bez przesyłania plików do chmury zewnętrznej, bez opłat za kroki decyzyjne i z pełną weryfikacją źródeł.
Mniej powtarzalnych pytań do ekspertów
Najczęstsze pytania obsługuje asystent, więc zespół wsparcia i konsultanci zajmują się sprawami, które naprawdę wymagają człowieka.
Wsparcie na każdym etapie projektu
Asystent pomaga zarówno przy planowaniu i weryfikacji wymogów (zasady pomocy publicznej, kryteria kwalifikowalności), jak i w codziennych wątpliwościach proceduralnych w trakcie realizacji.
Odpowiedź z odnośnikiem do źródła
Asystent korzysta wyłącznie z dokumentów Twojej organizacji i wskazuje rozdział, stronę oraz paragraf, więc każdą odpowiedź można sprawdzić u źródła.
Dostępność poza godzinami pracy
Pracownicy, beneficjenci i klienci uzyskują pomoc również wieczorem i w weekend, bez zwiększania zatrudnienia.
Co się zmienia w praktyce
Wyszukiwanie informacji skraca się z kilkudziesięciu minut przeglądania plików PDF do krótkiej rozmowy. Poufne wytyczne i dokumenty zostają przy tym w Twojej infrastrukturze i nie służą do trenowania publicznych modeli AI (RODO, EU AI Act).
Kompletny zestaw narzędzi do uruchomienia i działania RAG w Twojej firmie.
aamp nie jest konektorem do czyjejś usługi RAG. To pełny zestaw narzędzi: konfigurujesz bazę wiedzy i sposób jej indeksowania, obserwujesz wyszukiwanie i indeksowanie w trakcie działania oraz dostrajasz prompty dzielenia tekstu i inferencji — wszystko z jednej konsoli, na własnej infrastrukturze.
100% on-premise, gotowe na air-gap
System działa jako pojedynczy plik binarny (Single Go Binary) z wbudowaną bazą danych. Możesz go uruchomić bezpośrednio na stacji roboczej lub serwerze lokalnym bez dostępu do Internetu.
Precyzyjne cytowanie i weryfikowalne źródła
Każda odpowiedź opiera się na dostarczonym kontekście i zawiera odnośniki do konkretnych dokumentów źródłowych (PDF, DOCX, bazy danych), więc da się ją sprawdzić w źródle.
0% marży na tokenach, brak opłat za kroki
Płacisz za silnik orkiestracji, a nie za liczbę odpytań bazy wektorowej czy pętli decyzyjnych. Łącz system z dowolnym lokalnym silnikiem (Ollama, vLLM) lub własnym kluczem API.
Pełna izolacja i zgodność z RODO / EU AI Act
Dokumenty handlowe, umowy, dane medyczne i finansowe nie opuszczają Twojej infrastruktury. Zabezpiecz operacje dzięki sprzętowej izolacji Firecracker MicroVM oraz dwukierunkowej zaporze (Dual Safety Firewalls).
Zamień przestarzałą bazę wiedzy w bezpiecznego asystenta AI: konwersja w 4 krokach
Zdefiniuj bazę
Nazwij i opisz repozytorium, potem powiąż dostawcę LLM i model, który podzieli dokumenty na fragmenty.
Indeksuj na izolowanej mocy
Helper VM RAG Indexer parsuje i indeksuje dokumenty poza Twoimi głównymi systemami. Dodaj helper Jina Reader, gdy źródłem jest adres URL, a nie plik.
Wgraj, potem zindeksuj całą bazę
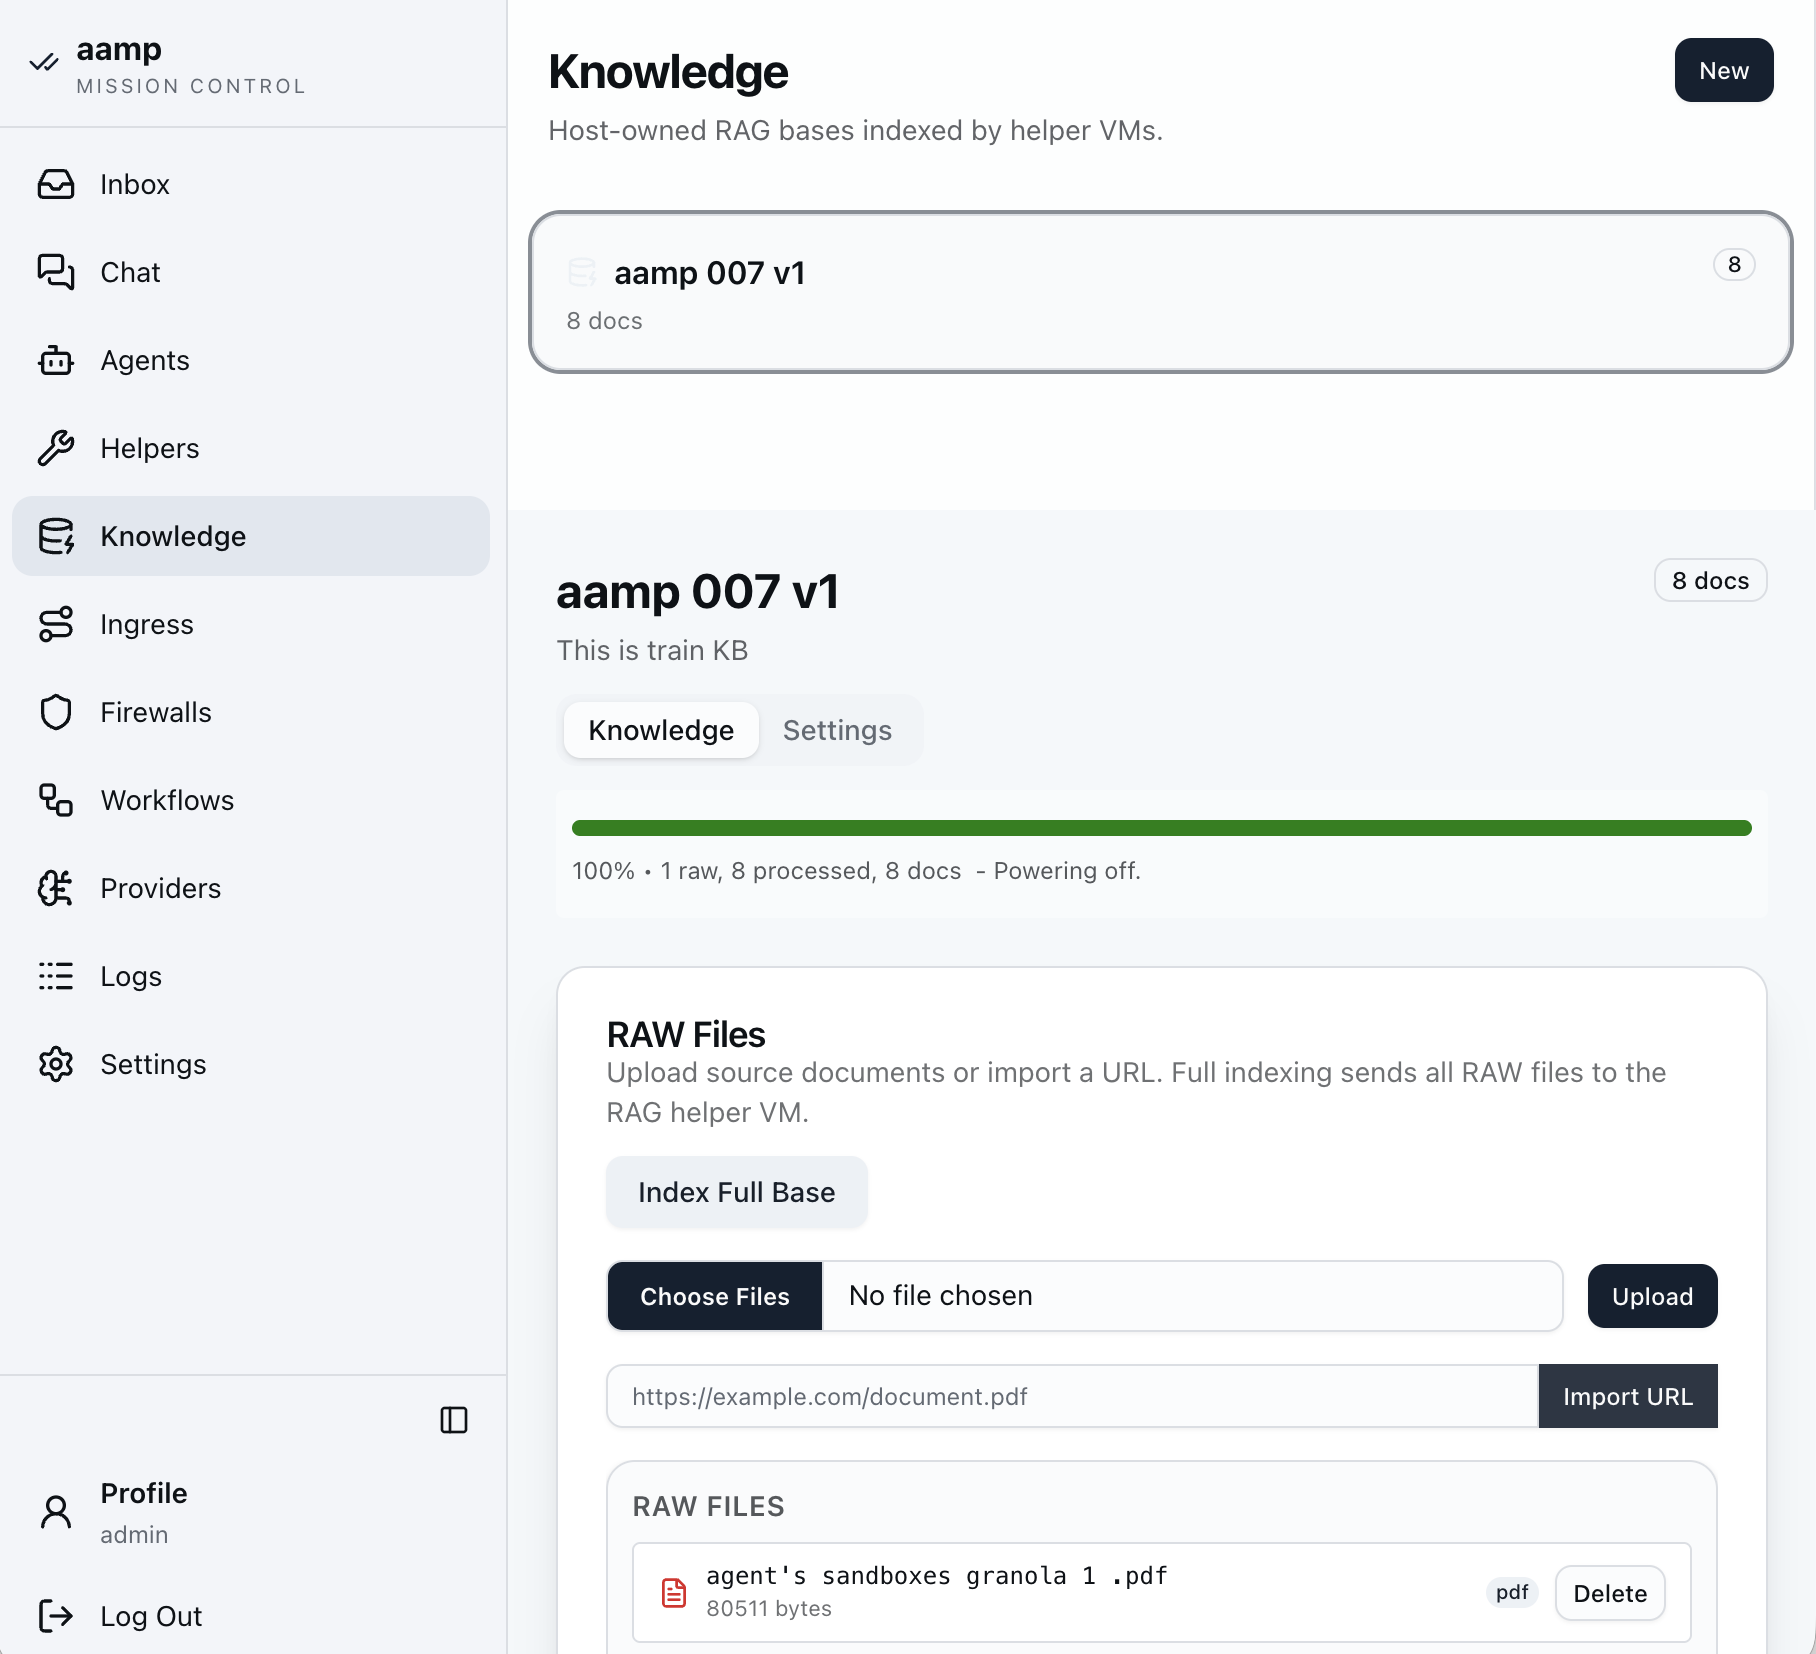
Surowe pliki leżą niezindeksowane, dopóki nie uruchomisz indeksowania. Pasek postępu pokazuje liczbę plików surowych, przetworzonych i dokumentów, aż helper się wyłączy.
Pytaj i dostawaj ugruntowane odpowiedzi
Agent szuka, czyta najlepsze dokumenty, przechodzi po powiązanych fragmentach i odpowiada na podstawie pobranych faktów — podając strony albo mówiąc, że dowodów brak.
Suwerenność jest tu wpisana w konstrukcję.
Cztery właściwości projektu, a nie cztery ustawienia, o których włączeniu trzeba pamiętać.
Każdą odpowiedź można sprawdzić w źródle.
Ścisły format JSON i śledzenie źródeł na poziomie strony dają pełną identyfikowalność. Każdą odpowiedź da się zweryfikować w wewnętrznym dokumencie źródłowym — i to właśnie zapobiega pewnym siebie wymysłom.
Żadna strona trzecia nie zatrzymuje Twoich dokumentów.
Indeksy żyją w środowiskach zarządzanych przez hosta, więc zewnętrzni dostawcy nie mogą zatrzymać firmowych danych ani na nich trenować.
Brak dowodów jest komunikowany, nie uzupełniany.
Polecenie modelowi, by zgłaszał brak dowodów, wymusza granicę zero-trust: żadnych nieuprawnionych założeń i żadnych wycieków między obszarami tematycznymi.
Przetwarzanie nie dotyka pamięci współdzielonej.
Przetwarzanie i indeksowanie działają na dedykowanych, izolowanych maszynach wirtualnych, trzymając surowe dokumenty i zadania indeksujące z dala od zewnętrznych wektorów sieciowych i współdzielonej pamięci.
Branże, w których kontrola danych jest wymogiem.
Indeksuj umowy, akty prawne i orzecznictwo ze śledzeniem cytowań na poziomie strony — na potrzeby due diligence i przygotowania pism.
Parsuj wytyczne kliniczne, badania medyczne i protokoły opieki, gdy dane pozostają wyłącznie w suwerennych maszynach wirtualnych.
Przeszukuj wewnętrzne logi audytowe, oceny ryzyka i złożone prospekty bez wystawiania firmowych danych na publiczne potoki treningowe LLM.
Zamień wewnętrzne repozytoria kodu, zapisy decyzji architektonicznych i logi systemowe w uporządkowany kontekst dla wsparcia operacyjnego i diagnostyki.
Indeksuj wrażliwe instrukcje techniczne, schematy serwisowe i dane łańcucha dostaw na własnej lub izolowanej infrastrukturze, spełniając wymogi suwerenności.